SSE = Streaming SIMD Extension

SIMD = Single Instruction Multiple Data
SSE to dodatkowe rozkazy, które pozwalają znacznie szybciej wykonywać obliczenia matematyczne, szczególnie te wykorzystywane w dziedzinie multimediów, co przekłada się na zwiększenie efektywności działania m.in. gier komputerowych, programów graficznych, muzycznych, kodowania filmów i muzyki.
- Nowe rejestry 128 bitowe XMM :
XMM0, XMM1, ..., XMM7 - 64 bitowe procesory dodają jeszcze
XMM8, ..., XMM15 - W odróżnieniu od rejestrów MMX są one zupełnie samodzielnymi rejestrami.
- SSE daje przede wszystkim możliwość wykonywania działań zmiennoprzecinkowych na 4-elementowych wektorach liczb pojedynczej precyzji (48 rozkazów).
Materiały pochodzą z polskiej Wikipedii i serwisu Ważniak
- SSE2 – 2000 rok (wprowadzone przez firmę Intel):
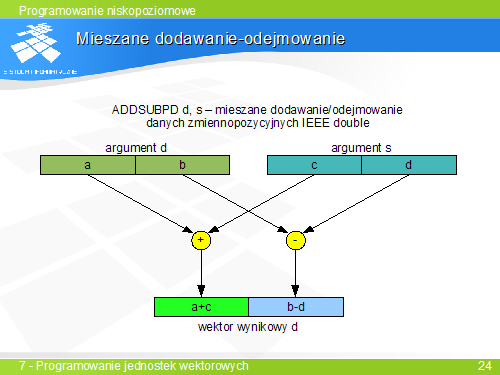
- wprowadzenie działań wektorowych i skalarnych na liczbach zmiennoprzecinkowych podwójnej precyzji,
- umożliwienie wykonywania działań całkowitoliczbowych na 128-bitowych rejestrach XMM,
- większa kontrola nad pamięcią podręczną.
- SSE3 – 2004 rok (Intel):
- dodatkowe rozkazy wektorowe działające na liczbach zmiennoprzecinkowych pojedynczej i podwójnej precyzji,
- sprzętowe wspomaganie synchronizacji wątków.
- SSSE3 – 2006 rok (Intel):
- dodatkowe rozkazy wektorowe działające na liczbach całkowitych,
- rozkaz umożliwiający wyznaczenie zadanej permutacji bajtów w rejestrze XMM.
- SSE4 – 2007 rok (Intel):
- dodatkowe rozkazy wektorowe działające zarówno na liczbach całkowitych jak zmiennoprzecinkowych,
- rozkazy wektorowe wspomagające kompresję wideo,
- rozkazy wektorowe wykonujące działania na łańcuchach znaków,
- rozkazy wyznaczający sumę CRC-32.
- SSE5 – 2009 rok (AMD):
- dodatkowe rozkazy wektorowe działające zarówno na liczbach całkowitych jak zmiennoprzecinkowych,
- wprowadzenie rozkazów trój- i czteroargumentowych, w który jeden z argumentów jest docelowy (rozwiązanie z architektury RISC) – dotychczas rozkazy były 2-argumentowe, z czego jeden był równocześnie docelowy i jeśli jego wartość była potrzebna w dalszej części obliczeń, należało go zapamiętać – w rozkazach 3- i 4-arguementowych takiego problemu nie ma,
- rozkazy 4-argumentowe pozwalają akumulować wyniki mnożenia według schematu
 .
- Advanced Vector Extensions – 2010 rok (Intel):
- dodanie nowych, 256-bitowych rejestrów: część istniejących rozkazów SSE, SSE2, SSE3 i SSSE3, głównie zmiennoprzecinkowych może wykonywać działania na tych rejestrach,
- kilka rozkazów wektorowych działających wyłącznie na 256-bitowych rejestrach,
- część istniejących rozkazów może być wykonywana wariantach 3-argumentowych (jak w SSE5),
- rozkazy 4-argumentowe pozwalają akumulować wyniki mnożenia na liczbach zmiennoprzecinkowych według schematu ,
- zwiększono z 8 do 32 liczbę relacji, które można sprawdzić rozkazami porównania (CMPPS, CMPPD),
- sprzętowe wsparcie szyfrowania AES.
- AVX2 - 2013 (Intel):
- Rozszerzenie operacji całkowitoliczbowych na rejestry YMM (256 bitowe)
- Przesunięcia bitowe
- Gather - ładowanie wektora niekoniecznie z ciągłej pamięci
- AVX-512 - 2016:
- Rozszerzenie rejestrów do 512 bitów i ich liczby do 32: ZMM0..ZMM31
- Rozszerzenie operacji aby działały dla 512 bitów
- Dodanie specjalistycznych rozszerzeń (opcjonalnych): VNNI - vector neural network instructions, GFNI - Galois field New instructions, VAES - vector AES, ...
 .
- wektor 2 liczb zmiennoprzecinkowych podwójnej precyzji (2 x 64 bity)
- wektor 4 liczb zmiennoprzecinkowych pojedynczej precyzji (4 x 32 bity; wprowadzony w SSE)
- Typy całkowite (rozszerzenia typów MMX):
- wektor 16 bajtów - packed byte (16 x 8 bitów)
- wektor 8 słów - packed word (8 x 16 bitów)
- wektor 4 podwójnych słów - packed duble words (4 x 32 bity)
- wektor 2 poczwórnych słów - packed quad words (2 x 64 bity)
- liczba 128-bitowa - long quadword
Rozkazy SSE mogą wykonywać działania arytmetyczne na wektorach liczb zmiennoprzecinkowych na dwa sposoby:
- packed (równoległe) — wykonując równocześnie dwa niezależne działania zmiennoprzecinkowe na odpowiadających sobie elementach wektorów;
- scalar (skalarne) — wykonując działanie tylko na pierwszych elementach wektorów.
Przykład – mnożenie dwóch wektorów (rozkazem MULPS xmm0, xmm1):
+-------+-------+-------+-------+
|   x3  |   x2  |   x1  |   x0  | xmm0
+-------+-------+-------+-------+
    *       *       *       *
+-------+-------+-------+-------+
|   y3  |   y2  |   y1  |   y0  | xmm1
+-------+-------+-------+-------+
    =       =       =       =
+-------+-------+-------+-------+
| x3*y3 | x2*y2 | x1*y1 | x0*y0 | xmm0
+-------+-------+-------+-------+
Przykład – mnożenie pierwszych elementów wektorów (rozkazem MULSS xmm0, xmm1 ):
+-------+-------+-------+-------+
|   x3  |   x2  |   x1  |   x0  | xmm0
+-------+-------+-------+-------+
                            *
+-------+-------+-------+-------+
|   y3  |   y2  |   y1  |   y0  | xmm1
+-------+-------+-------+-------+
    =       =       =       =
+-------+-------+-------+-------+
|   x3  |   x2  |   x1  | x0*y0 | xmm0
+-------+-------+-------+-------+
Przykład – mnożenie dwóch wektorów (rozkazem MULPD xmm0, xmm1):
+-------+-------+-------+-------+
|      x1        |      x0      | xmm0
+-------+-------+-------+-------+
    *       *       *       *
+-------+-------+-------+-------+
|       y1      |       y0      | xmm1
+-------+-------+-------+-------+
    =       =       =       =
+-------+-------+-------+-------+
|     x1*y1     |     x0*y0     | xmm0
+-------+-------+-------+-------+
- MOVAPS, MOVUPS
Przesłanie 4 liczb zmiennoprzecinkowych pomiędzy rejestrem XMM, a pamięcią lub innym rejestrem XMM:
- MOVAPS — wymaga, by adres pamięci był wyrównany do granicy 16 bajtów, tj. jego 4 najmłodsze bity muszą być równe zero – w przeciwnym przypadku zgłaszany jest błąd.
- MOVUPS — nie nakłada takich ograniczeń, ale odczyt danych niewyrównanych jest zwykle wolniejszy.
- MOVSS Przesłanie jednej liczby zmiennoprzecinkowej pomiędzy rejestrem XMM, a pamięcią lub innym rejestrem XMM. Rozkaz działa na elemencie 0 rejestrów XMM: przy przesłaniach z rejestru do rejestru tylko on jest zmieniany, przy przesłaniu z pamięci do rejestru zerowane są pozostałe elementy.
- MOVLPS, MOVHPS Przesłanie 2 liczb zmiennoprzecinkowych pomiędzy rejestrem XMM i pamięcią. Rozkaz MOVLPS działa na elementach 0 i 1 rejestru XMM, natomiast MOVHPS na elementach 2 i 3.
Dla nazw instrukcji sufiks nazwy określa typ:
- PD (packed double) – działanie na wektorach podwójnej precyzji,
- PS (packed single) – działanie na wektorach pojedynczej precyzji,
- SD (scalar double) – działanie na skalarach podwójnej precyzji.
- SS (scalar single) – działanie na skalarach pojedynczej precyzji.
- dodawanie (ADDPD, ADDPS, ADDSD, ADDSS)
- odejmowanie (SUBPS, SUBSS)
- mnożenie (MULPS, MULSS)
- dzielenie (DIVPS, DIVSS)
- przybliżenie odwrotności (1/x) (RCPPS, RCPSS)
- pierwiastek kwadratowy (SQRTPS, SQRTSS)
- przybliżenie odwrotności pierwiastka kwadratowego (RSQRTPS, RSQRTSS)
- wyznaczenie minimalnej wartości (MINPS, MINSS)
- wyznaczenie maksymalnej wartości (MAXPS, MAXSS)
- Może być stosowany tylko do skalarów!
- Porównują dwie liczby zmiennoprzecinkowe i ustawiają flagi procesora: rowny, mniejszy, wiekszy, nieokreslony(gdy jedna z liczb jest NaN),
COMISS, COMISD– sygnalizuje błąd gdy wystąpi nieprawidłowa liczba zmiennoprzecinkowa QNaN lub SNaNUCOMISS, UCOMISD– sygnalizuje błąd tylko w przypadku SNaN
Dla tych elementów, dla których wynik porównania jest prawdziwy wszystkie bity w rejestrze docelowym są ustawiane, gdy nieprawdziwy – zerowane. Ten sposób porównania może być zastosowany zarówno dla wektorów (rozkaz CMPPS) jak i skalarów (rozkaz CMPSS)
Przykład testowania, czy liczby są różne (rozkaz CMPNEQPS xmm0, xmm1[1]):
 +---------+---------+---------+---------+
 |   1.0   |  -5.3   |   16.5  |   17.2  | xmm0
 +---------+---------+---------+---------+
      ≠         ≠         ≠         ≠
 +---------+---------+---------+---------+
 |   7.0   |  -5.3   |   16.5  |   17.3  | xmm1
 +---------+---------+---------+---------+
      =         =         =         =
 +---------+---------+---------+---------+
 |111..1111|000..0000|000..0000|111..1111| xmm0
 +---------+---------+---------+---------+
- Ustawienia operacji zmiennoprzecinkowych:
- sposób zaokrąglanie wyniku:
- do najbliższej liczby całkowitej
- zaokrąglanie w stronę plus nieskończoności
- zaokrąglanie w stronę minus nieskończoności
- ucinanie (zaokrąglanie w stronę zera)
- flaga flush-to-zero – jeśli ustawiona w przypadku niedomiaru zamiast zgłaszania wyjątku, zapisywana jest liczba zero; działanie nie jest zgodne ze standardem, ale powoduje przyspieszenie programów
- sposób zaokrąglanie wyniku:
- Maski włączające zgłaszanie wyjątków przy błędach; wykrywane błędy:
- niewłaściwe argumenty (np. pierwiastkowanie ujemnej liczby),
- dzielenie przez zero,
- nadmiar (wynik jest zbyt duży),
- niedomiar (wynikiem jest liczba nie znormalizowana),
- niedokładny wynik (wynik nie może być dokładnie reprezentowany).
- Flagi wskazujące rodzaj błędu – ustawiane automatycznie przez procesor, niezależnie od tego, czy dany błąd jest zgłaszany, czy nie; muszą zostać wyzerowane programowo (zwykle w procedurze obsługi wyjątków SSE).
Dane nie wyrównane
Dane wyrównane
Funkcje liczące iloczyn
SSE_u - SSE dane nie wyrównane
SSE_a - SSE dane wyrównane
FPU - kooprocesor numeryczny
C++ - implementacja w C++ używa SSE ale nie wektorowo.
C++(-O2) - implementacja w C++ z optymalizacją używa SSE wektorowo.
Test 1: duże tablice
Test 3: małe tablice
Wyniki Pentium Core 2 Duo
| SSE_u | SSE_a | FPU | C++ | C++(-O2) | |
|---|---|---|---|---|---|
| Test 1 | 28.5 | 28.0 | 29.3 | 55.3 | 27.7 |
| Test 2 | 0.63 | 0.31 | 1.03 | 5.05 | 0.31 |
Wyniki Pentium Core i7
| SSE_u | SSE_a | FPU | C++ | C++(-O2) | |
|---|---|---|---|---|---|
| Test 1 | 8.04 | 8.02 | 8.04 | 30.44 | 8.04 |
| Test 2 | 1.343 (1.557) | 1.243 | 5.221 | 29.923 | 4.790 |
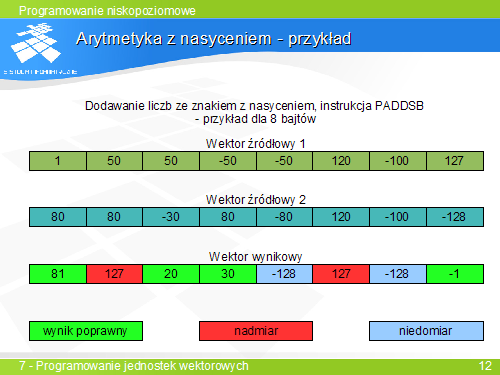
- Przy operacjach wektorowych na liczbach całkowitych może dojść do przepełnienia i "zawinięcia wyniku", co powoduje dużą niedokładność.
- Operacje dodawania i odejmowania z nasyceniem w przypadku nadmiaru lub niedomiaru zwracają odpowiednio wartość maksymalna i minimalna dla danego typu.
- Istnieją odpowiednie instrukcje dla liczb ze znakiem: PADDS, PSUBS oraz bez znaku PADDUS, PSUBUS
- Chcemy wykonać różne operacje dla różnych elementów wektora w zależnośći od spełnienia dla danych elementów pewnego warunku.
- Chcemy uniknąć instrukcji if która znacznie spowalnia.
Rozwiązanie:
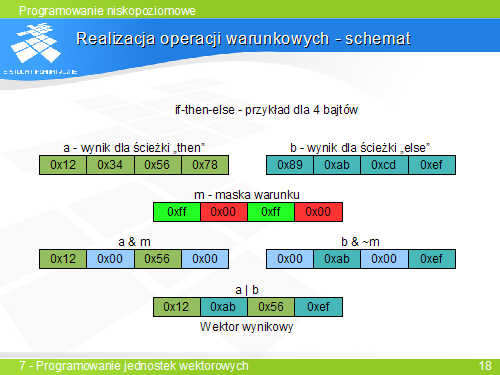
- Wektorowe operacje logiczne zwracają maski bitowe M (dla elementów dla których warunek był spełniony na odpowiednim miejscu są same jedynki).
- obliczamy dwie możliwe wartości wyniku : Vt - dla przypadku spełnienia warunku i Vf dla niespełnienia.
- Wykonujemy iloczyn logiczny Vt z maską M i odpowiedznio Vf z ~M
- Ostateczny wyniki jest sumą logiczna tych wyników
(Vt & M) | (Vf & ~M)
section .data
const40  'MMMMMMMMMMMMMMMM'
star     '****************'

section .text

; if(x <= 'M') x = '*';

sse_if:
    movdqu  xmm0, [rdi]       ; MOVe Double Quadword [Aligned]
    movdqu  xmm1, [const40]  ; wektor stałych 40
    movdqa  xmm2, xmm0       ;

    pcmpgtb xmm2, xmm1       ; xmm2  zawiera maske

    movdqa  xmm1, [star]

    pand    xmm0, xmm2       ; zerujemy znaki mniejsze niż M
    pandn   xmm2, xmm1       ; ustawiamy tam gwiazdki
    por     xmm0, xmm2       ; sumujemy

    movdqu  [rdi], xmm0

    ret
Przykład
Tomasz Kapela, Kraków 2011-2020